Kimi K3 技术报告 · 白话解读版
月之暗面 2.8T 参数开源大模型的技术报告,全文 47 页、满是数学公式和系统工程术语。这份解读把它翻译成人话:每章讲了什么、为什么重要、对我们意味着什么。
用三句话讲完这份报告
Kimi K3 是月之暗面开源的最大模型:总参数 2.8T,但每次只动用 104B(约 3.7%),上下文最长 100 万 token,天生能看图看视频。
② 怎么把它练出来? 预训练(§3)→ 强化学习出九个专家(§4)→ 蒸馏合并成一个模型。
③ 怎么让它跑得起来? 从训练到推理的一整套基础设施工程(§5)。
引言:为什么这件事值得关注
Introduction过去做大模型,大家的思路是「训练前投入更多算力」——模型越大、数据越多,效果越好。这是第一条扩展轴。
推理模型的兴起带来了第二条扩展轴——测试时计算:让模型在回答问题时多想一会儿(强化学习 + 更长推理),效果也会变好。OpenAI 的 o 系列、Anthropic 的 extended-thinking、DeepSeek-R1 都是这条路上的玩家。
这一章的潜台词是战略级的:开源社区需要一个「地基足够大」的模型,否则推理增强的天花板会被预训练基座锁死。K3 就是在补这块短板。
模型架构:三大创新 + 视觉 + 优化器
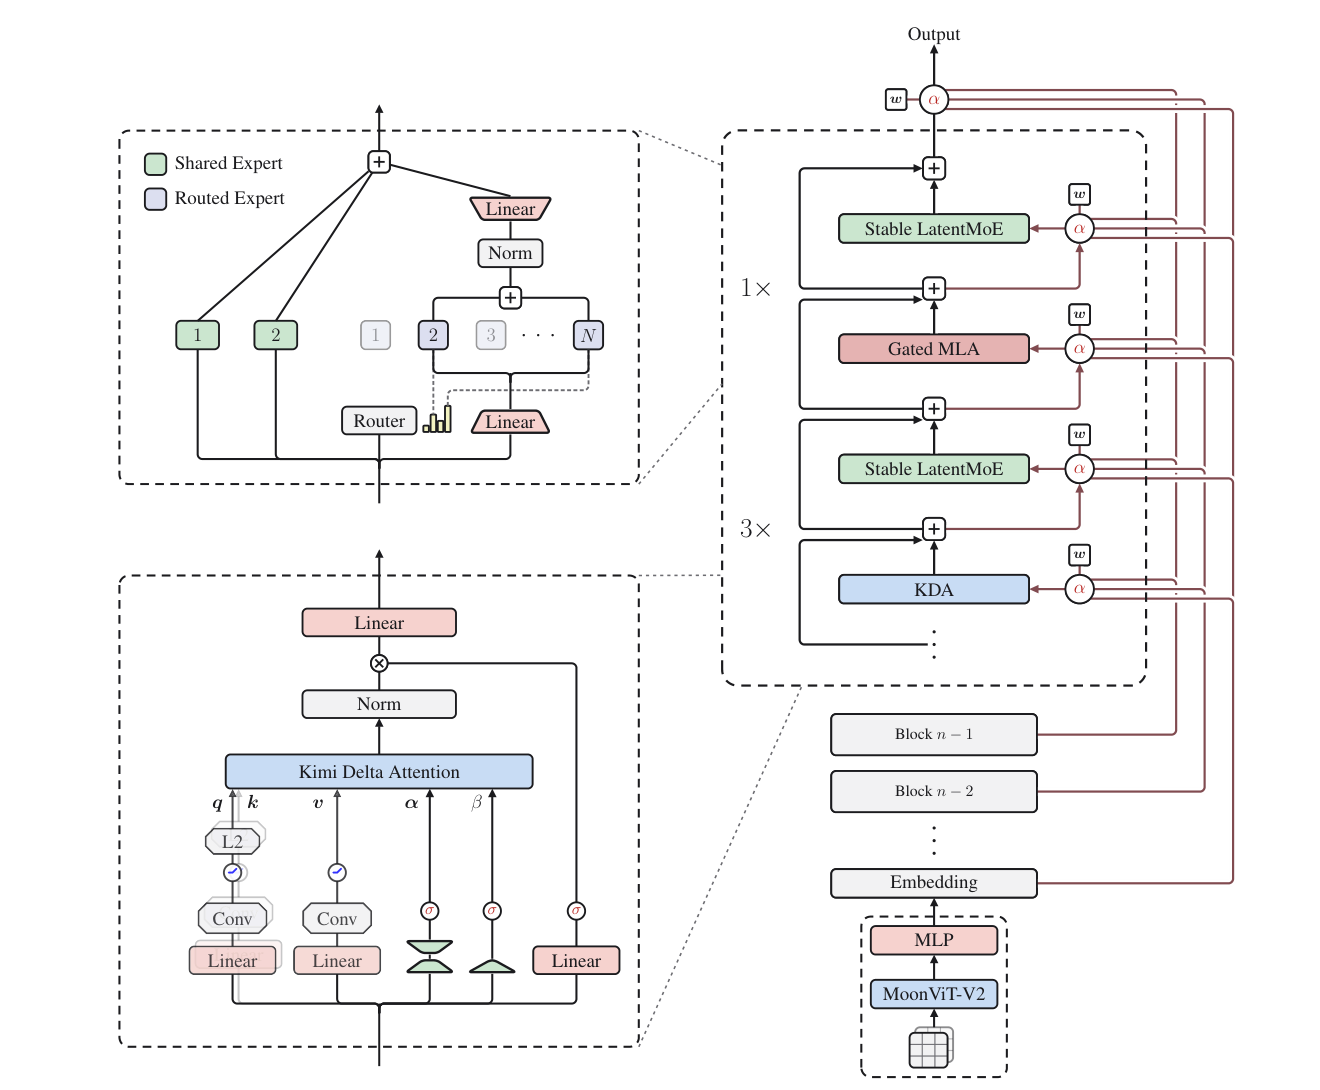
Model Architecture这一章是全文最硬核的部分,也是理解 K3 的关键。核心思路一句话:沿着序列、深度、宽度三个维度,让信息在模型里流动得更充分、更便宜。
2.1 混合注意力:一个「高速缓存 + 全量档案室」的组合
K3 的每个块(block)里有 4 个注意力层,按 3 个 KDA + 1 个 Gated MLA 的比例排列(3:1 混合,末层强制全局注意力)。两种注意力分工不同:
| 组件 | 全称 | 角色(人话) | 特点 |
|---|---|---|---|
| KDA | Kimi Delta Attention | 「人脑记忆本」:用固定大小的记忆状态持续更新,擅长处理超长序列 | 线性注意力,随序列增长几乎不额外占内存 |
| Gated MLA | 门控多头潜注意力 | 「全量档案室」:每次能精确回看任意历史位置 | 全局交互,KV 缓存压缩到低维潜向量 |
三个工程改进让它在硬件上跑得快:
• 下界受限衰减:把「遗忘速度」限制在一个范围内,避免数值溢出,从而所有计算都能用 GPU 的稠密矩阵乘法(之前对角块必须用慢速的位置对计算)
• 全秩门控:输出前按输入内容动态决定「这个位置该输出多少」
• FP32 注意力输出:修正低精度舍入误差,用内核重设计抵消显存翻倍
2.2 Attention Residuals:让每一层都能「直连」前面所有层
传统残差连接(ResNet 式)的问题:信息从第一层传到第 100 层,中间每层都要「转手」,最后全被压进一个单一状态——就像传话游戏,传得越远越失真。
全量版代价较高,所以工程上用「块级」版本:每 12 层合成一个「块纪要」(求和归约),跨块时只对块纪要做注意力。内存开销从 O(Ld) 降到 O(Nd),推理也更快。K3 把层分成 8 块,加上嵌入层共 9 个块。
2.3 Stable LatentMoE:896 个顾问,每次只请 16 个
混合专家(MoE)的思路:不训练一个「全知全能」的模型,而是训练几百上千个「专家」,每个 token 只激活少数几个。K3 把专家数扩到 896 个路由专家 + 每层 2 个共享专家,每个 token 激活 16 个,稀疏度 56。
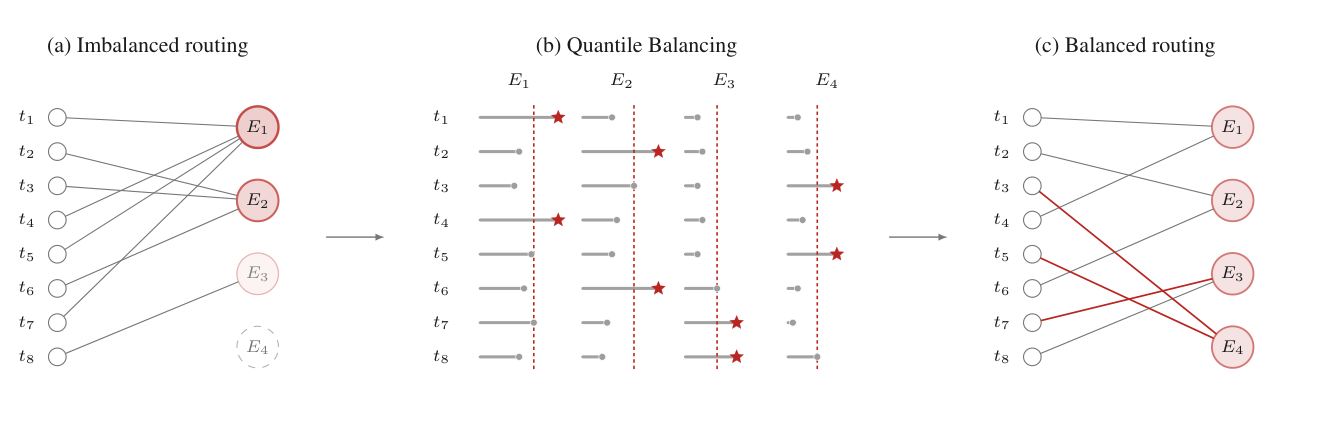
但极端稀疏(896 选 16)暴露了两个老问题:路由分支里激活值爆炸(数值越算越大);近千个专家的负载均衡很难做。K3 用三招解决:
| 招数 | 解决什么问题 | 人话解释 |
|---|---|---|
| 归一化 LatentMoE | 路由分支尺度不稳定 | 在专家聚合后、升维前加一个 RMSNorm,让数值保持稳定,还顺带改善了效果 |
| SiTU-GLU | 激活值爆炸 | 给 SwiGLU 激活函数「戴上安全带」:乘积的两个因子都被限制在有限范围内(|f(x)| ≤ 100),保留 SwiGLU 的形状又不会爆炸 |
| Quantile Balancing (QB) | 896 个专家负载不均 | 传统方法按固定步长微调偏置,反应慢;QB 直接从一次前向的数据中算出「每个专家该拿多少 token」的最优偏置——像按分位数排队,一步到位,无需学习率 |
2.4 原生视觉:图像视频是「一等的公民」
K3 是原生多模态的:文本、图像、视频由同一个共享骨干处理,不是事后拼接一个视觉编码器。关键差异是视觉编码器 MoonViT-V2 完全从零训练(27 层、约 0.4B 参数),不再用 SigLIP 等预训练模型初始化。
视觉细节:2×2 pixel-shuffle 下采样把视觉 token 压缩四分之一,最高支持 3584×3584 像素输入;注意力分解为帧内空间 + 帧间时间两条通路。
2.5 Per-Head Muon:更细粒度的优化器
K3 用 Muon 优化器(K2 沿用),但对注意力投影做了「逐头」改进:不再对整个 Q/K/V 矩阵做一次正交化,而是按注意力头切分、每个头单独做。原因:全矩阵正交化会让「头大」的注意力头主导更新方向,「头小」的得不到充分更新。逐头化之后,各头学习动态更均衡、大模型训练更稳定,还顺带省了点开销。
预训练:喂什么、喂多少、怎么喂
Pretraining3.1 数据:四大文本领域 + 大规模视觉语料
文本:Web 文本、代码、数学、知识四大领域,每个都经过规则启发式 + 分类器打分 + 去重三重过滤;知识与数学语料还做了「改写」(用多样化的提示重写,再对照原文校验保真度)。
视觉:图像描述、图文交错文档、OCR、感知、视频、视觉编程;坐标监督同时给绝对和归一化两种格式(精确定位 + 分辨率鲁棒);还大规模扩展了「程序化多模态数据」——把代码片段和它渲染出的视觉结果配对(SVG、3D 资产、网页、游戏、CAD)。
3.2 规模定律:2.5× 是怎么来的
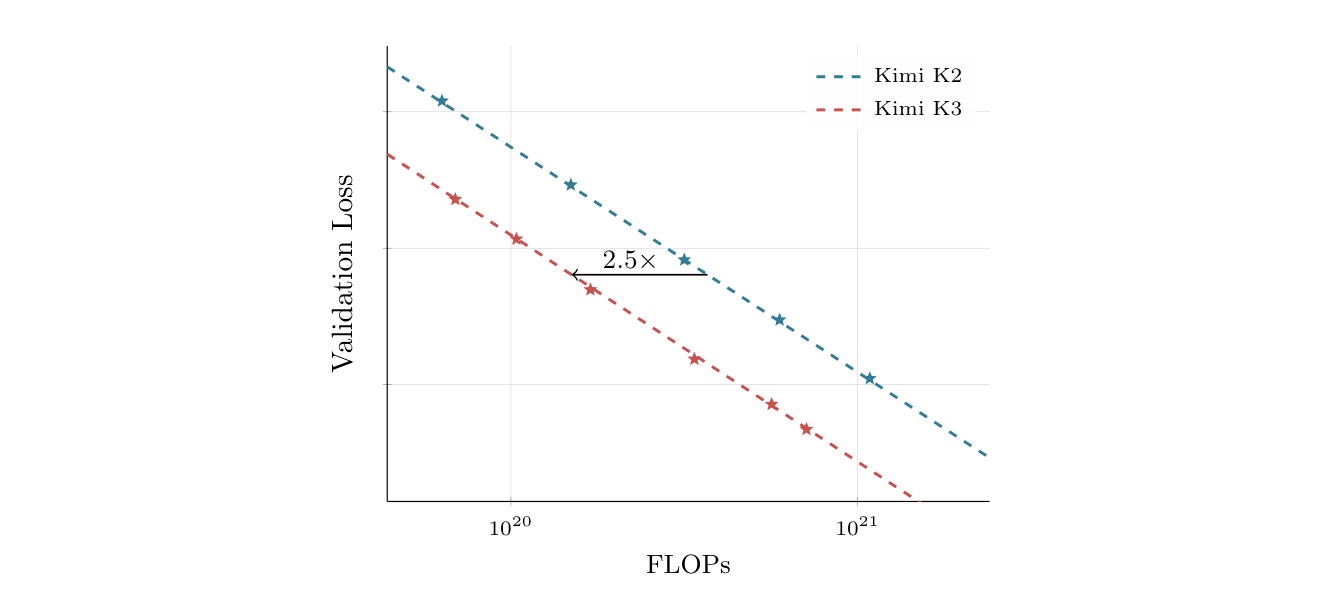
架构改了,最优训练区间也变了,所以要重新做「规模定律」研究(batch size、学习率、token 与参数比、模型形状)。结果:这些改进合计带来相较 K2 约 2.5× 的整体规模效率提升。
3.3 训练配方:语言视觉从一开始就一起学
原生多模态策略:视觉和文本在同一个「下一 token 预测」目标里交错出现,从训练第一天起就联合优化——不是先练语言、再嫁接视觉。
3.4 长上下文扩展:怎么撑到 100 万 token
三件事配合:
| 手段 | 人话解释 |
|---|---|
| NoPE(无显式位置编码) | 位置信息由 KDA 的循环衰减隐式编码,扩上下文时不需要调整位置编码参数(其他模型要改 RoPE 频率或做插值) |
| 长上下文数据管线 | 长文档/长视频要先清洗(去重、去二进制 blob、帧级感知哈希);真长且连贯的数据稀缺要上采样;更关键的是合成数据——把任务重排拼接,让问题只有关注散布在 100 万 token 中的信息才能解决 |
| 渐进式上下文扩展 | 课程式拉长:预训练 8K→64K,cooldown 阶段 256K→100 万。把昂贵的长序列计算集中在小部分预算里 |
后训练:从「会说话」到「会干活」
Post-training预训练让模型会语言,后训练让它会做事。K3 的三阶段配方:SFT(打基础)→ RL(出专家)→ MOPD(合并成一人)。
4.1 三阶段方法
① 通用任务(体验、视觉、推理、忠实性、搜索、知识工作)
② 通用智能体(长周期助手、深度研究、段落级写作)
③ 编程智能体(软件工程、编程体验、内核任务、Web 开发)
每个领域配 {low, high, max} 三档推理力度。
训练发现:RL 算力投入越多,工具调用步数持续增长,各项能力全面提升(图 8)。
RL 里的三个精巧机制
| 机制 | 解决什么问题 | 做法 |
|---|---|---|
| 部分 rollout | 长周期任务里「跑得慢的轨迹」拖累整体 | 不等待所有 rollout 结束,完成比例到 λ 就先暂停、推进策略更新;暂停的进队列下次优先恢复(靠沙箱基础设施支持) |
| 推理力度 RL | 控制「想多久」,兼顾效果和 token 成本 | 每个问题有初始 token 预算,超过阈值 τ×b₀ 的轨迹奖励直接判 -1;τ 按阶段课程从大到小退火,得到 max/high/low 三档 |
| 生成式奖励模型 (GRM) | 不可自动验证的任务怎么给奖励 | 让模型当评委:先读产物 → 生成评分细则 → 按细则打分 → 记入记分板;对「写很长来骗分」施加冗长度控制 |
面向部署的两件事
MXFP4 量化感知后训练:MoE 专家权重量化到 MXFP4(占显存大头),激活 MXFP8,非专家组件保持高精度;整个 SFT+RL 全程做 QAT,RL 期间训练和推理共用同一量化方案(消除训练-推理不一致)。
草稿模型微调(投机解码加速):把预训练自带的 MTP 层微调成 EAGLE-3 风格的草稿模型——小模型先「猜」,大模型验证,猜中了就跳着生成,速度翻倍。草稿输入融合目标模型的低/中/高层特征,直接优化「接受率」而不是 KL 散度(LK 损失)。
4.2 任务合成与智能体环境:怎么造出好「练习题」
RL 效果高度依赖环境的质量和多样性。K3 造了六类环境:
| 环境 | 人话解释 |
|---|---|
| 统一白盒 RL 环境 | 把智能体框架拆成可配置模块(工具接口、系统提示、记忆、子智能体……),能实例化 Kimi Code、Claude Code、Codex、OpenClaw、Hermes 等各种 harness,训练时动态组合——不让模型过拟合单一框架 |
| 知识图谱引导的任务合成 | 建一个自我进化的「知识地图」(智能体上网调研、节点按粗→细组织),从地图采样概念 → 生成关键词 → 检索真实材料 → 合成任务,保证任务又专又广 |
| 可验证问题 | 多步信息检索、投行/数据分析/法律等专业人士的日常工作、多步可验证的视觉推理(模型写 Python 裁图、缩放、计算、验证,把执行输出当新观测) |
| 内核优化任务 | 让模型写 GPU 内核(CUDA/Triton/CuTe/Gluon/ThunderKittens/TileLang),奖励同时看正确性和性能,还有作弊检测系统惩罚 CUDA 图重放、输入缓存、精度降级等投机行为 |
| 个人助手任务 | Gmail/Notion/Slack/Canvas 的高保真模拟,跨多个模拟日、几十个相互依赖的事件,单次 rollout 数千次工具调用、数百万上下文 token |
| 自主执行任务 (AET) | 给初始状态 + 目标 + 工具 + 预算 + 独立验证器,模型自己拆解任务、规划、纠错、决定何时结束;奖励只看验证器对最终状态的评估,不看模型自夸。公开验证器 + 隐藏验证器配对防作弊 |
还有第七类:Web 开发任务(网站、游戏、3D/WebGL、SVG、全栈应用),确定性功能测试 + 模型评判双重打分。
基础设施:怎么把 2.8T 的大家伙练出来、跑起来
Infrastructure模型再强,练不出来、跑不快也白搭。这一章是系统工程师的主场,讲了三组挑战:KDA 注意力怎么在 GPU 上高效跑、3T 级 MoE 怎么均衡训练、百万 token 智能体怎么强化学习。
5.1 KDA 的算法-系统协同设计
KDA 用固定大小的循环状态取代不断增长的 KV 缓存——状态小是优点,但「串行更新」和 GPU「喜欢并行」冲突。解法分三层:
| 层面 | 方案 | 人话解释 |
|---|---|---|
| 设备内 | FlashKDA 融合内核 | 把块内并行计算和跨块状态传播重叠起来,性能远超 Triton 参考实现 |
| 设备内 SM 级 CP | 自动规划器 | 长序列预填充时,把序列切到单个 GPU 的各 SM 上并行算分段、再精确合并,不产生跨设备通信 |
| 跨设备 | KDA 上下文并行 (KCP) | KDA 的 delta 规则让「直接求和」失效(上一段的效果取决于进入该段的状态),KCP 把每个分段分解成「累积转移 + 从零算出的状态」两个量,一次固定大小 all-gather 完成同步,线性扩展 |
5.2 3T 级预训练基础设施
三个老大难:专家并行时 token 负载不均;激活/梯度/优化器状态超显存;视觉编码器计算量可变、暴露在关键路径。对应三个方案:
• 显存高效 MoE:数学变换去掉反向传播对 output 的依赖;dispatch 输入重算省激活
• 显存高效 AttnRes:块表示只物化一次 + 检查点包裹,显存达到理论下界
• 跨 PP rank 平衡:用 Mooncake Transfer Engine 把激活远程卸载到别的 rank
• P2P 的 Muon 正交化:只取回自己需要的参数分片,替代整缓冲区 all-gather
5.3 百万 token 智能体 RL 的基础设施
目标是:一个百万上下文的 RL 实验只占几百张 GPU。两个手段:
| 手段 | 做法 |
|---|---|
| 外部 KV 缓存池 | 写回式设计:活跃解码块留 GPU,空闲前缀写回 CPU DRAM 池,复用前预取;KDA 状态和 MLA 缓存同生共死;迭代间隙把训练状态卸载到 NVMe 腾地方 |
| Rollout 自动限流 | 用活跃请求数、排队数、KV 利用率等信号动态控制并发,早期吃饱、后期不爆 |
| 梯度缓冲区复用 | 参考模型权重太大不能常驻 GPU → 塞进策略模型的 FP32 梯度缓冲区槽位,逐块流入,零新增显存 |
• 暂停/恢复:模型思考时(占沙箱生命周期最多 98%)把沙箱暂停,不占资源
• Fork:从精确状态复制新沙箱,用于无副作用的奖励评判
• 快照:固定间隔保存,出错可恢复
增量检查点只存脏内存页,检查点 133ms、恢复 49ms;内存超配比最高 6.5×。训练全程创建了 5121.9 万个沙箱(基于 150 万个镜像)。
5.4 推理与在线服务
服务侧三个挑战:混合 KDA–MLA 维护两种本质不同的缓存;新模块需要定制内核;生产流量单请求成本横跨三个数量级。
| 层面 | 方案 | 人话解释 |
|---|---|---|
| 引擎 | KDA 感知的前缀缓存 | 把 KDA 固定大小状态和 MLA KV 缓存装进同一个分页池,统一分配/引用/换出;细粒度哈希(512 token)与粗粒度物理块解耦,任何共享前缀都能在任意 512-token 边界复用——一个 2800 token 的请求能命中 2560 处继续算 |
| 设备 | 高性能内核 | KDA 解码用「缓存投影输入 + 片上重建状态」支持投机解码回滚;AttnRes 用序列并行省显存、旁路流藏延迟;LatentMoE 融合降投影与路由器、权重切分 + multimem 指令、WarpDecode 风格 token 中心内核 |
| 集群 | 缓存感知调度 + 预算准入 | 一致性哈希把每个会话固定到「主集群 + 备集群」,缓存局部性保住了、单点故障代价有界;按请求类别分配独立资源预算,长上下文突发流量拉不低全局 SLO |
评测:到底有多强、强在哪、贵不贵
Evaluation6.1 主要结果(四大能力轴线)
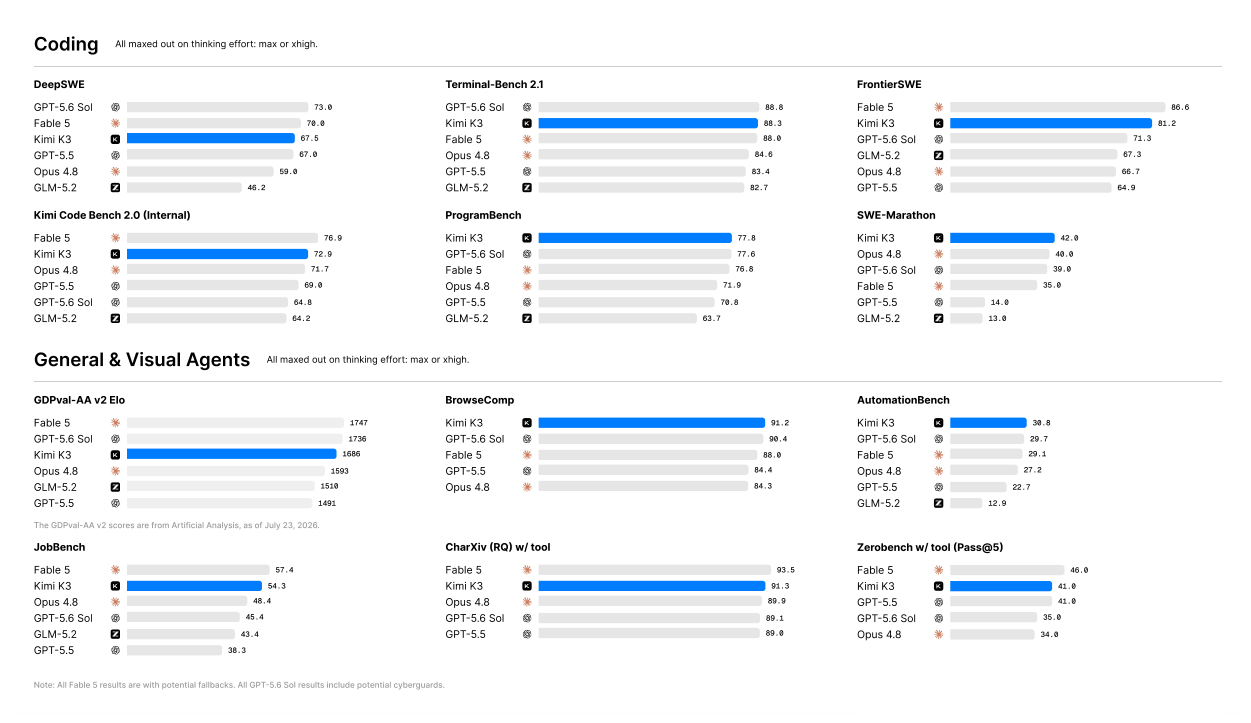
评测对手:最强闭源 Claude Fable 5、GPT-5.6 Sol(下称「双雄」),以及 Claude Opus 4.8、GPT-5.5、开源 GLM-5.2。总体结论:紧追双雄,稳定领先其他所有模型。
| 轴线 | 亮点(K3 成绩) | 短板 |
|---|---|---|
| 推理与知识 | GPQA Diamond 93.5%(研究生级推理与前沿持平);HLE-Full 用工具 56.0% | 研究级任务仍有差距:CritPt 23.4%,落后双雄和 GPT-5.5;HLE 无工具 43.5% |
| 编程 | ProgramBench 77.8% 全场最佳;SWE-Marathon 42.0% 领先 Claude Fable 5 达 7 个点;Terminal-Bench 88.3% 几乎追平 GPT-5.6 Sol(88.8%);FrontierSWE 81.2% 第二 | DeepSWE 排在双雄之后(官方榜单 67.3) |
| 智能体 | 一大串第一:BrowseComp 91.2%、DeepSearchQA F1 95.0%、ResearchRubrics 76.2%、MCPMark 94.5%、AutomationBench 30.8%、SpreadsheetBench 34.8%、τ³-Banking 33.4%、Harvey Lab-AA 94.6% | 两个 Elo 评级知识工作套件被 Claude Fable 5 领先(GDPval-AA v2 第三 1686、AA-Briefcase 第二 1548);更难的计算机关机使用基准(OSWorld 2.0、SaaS-Bench)仍由双雄领先 |
| 视觉 | Math-Vision 94.3% → 用 Python 后 97.8%;ZeroBench-main 23.0% → 41.0%;OmniDocBench 91.1% 最高;WorldVQA 51.0% 第二 | —— |
6.2 内部评测:更细的放大镜
网络安全评测(这版报告独有的内容)
按操作风险分两级:Tier 1 漏洞发现(防御向)和 Tier 2 漏洞利用开发(攻击向,最敏感)。
| 层级 | 结果 |
|---|---|
| Tier 1 漏洞发现 | 在数十个广泛部署系统(内核、数据库、AI 服务、Web 框架、区块链、VPN)中识别出数百个候选漏洞,人工复核约 70% 为真漏洞,含 16 个此前未知的漏洞。两个 Linux 内核大发现:可远程触发的堆越界写(DoS 原语)、RDMA 子系统里 Dirty-COW 级漏洞(本地提权原语) |
| Tier 2 漏洞利用 | 36 个任务解出 14 个(38.9%),GLM-5.2 为 8 个(22.2%);但 14 个里 10 个来自用户态赛道,内核赛道两者都解不出四分之三。失败模式:利用链收尾难、缓解下策略选择不当、陷入冗长调试、提交前验证不足。UK AISI 与 NIST CAISI 的独立评估结论一致 |
报告强调:这些数字是「能力下界」——受当前模型版本和评测覆盖范围限制,会随每次重大更新重新评测。
6.3 第三方评测:别人考它,成绩单也很亮
| 机构 | 成绩 |
|---|---|
| Artificial Analysis | Intelligence Index v4.1 = 57.1,580 个模型中排名第 4(双雄 59.9 / 58.9 之后) |
| Vals AI | Vals Index 74.7%,39 个模型中第 2,仅落后 Claude Fable 5(75.1%),领先 GPT-5.6 Sol(73.1%) |
| Arena | WebDev Arena 1678 Elo 登顶第一(99 个模型,领先 Claude Fable 5 的 1634)——首个登顶的开源模型;Text Arena 1486 Elo 第 8;Agent Arena 第 4 |
6.4 成本效率:闭源模型的「零头」
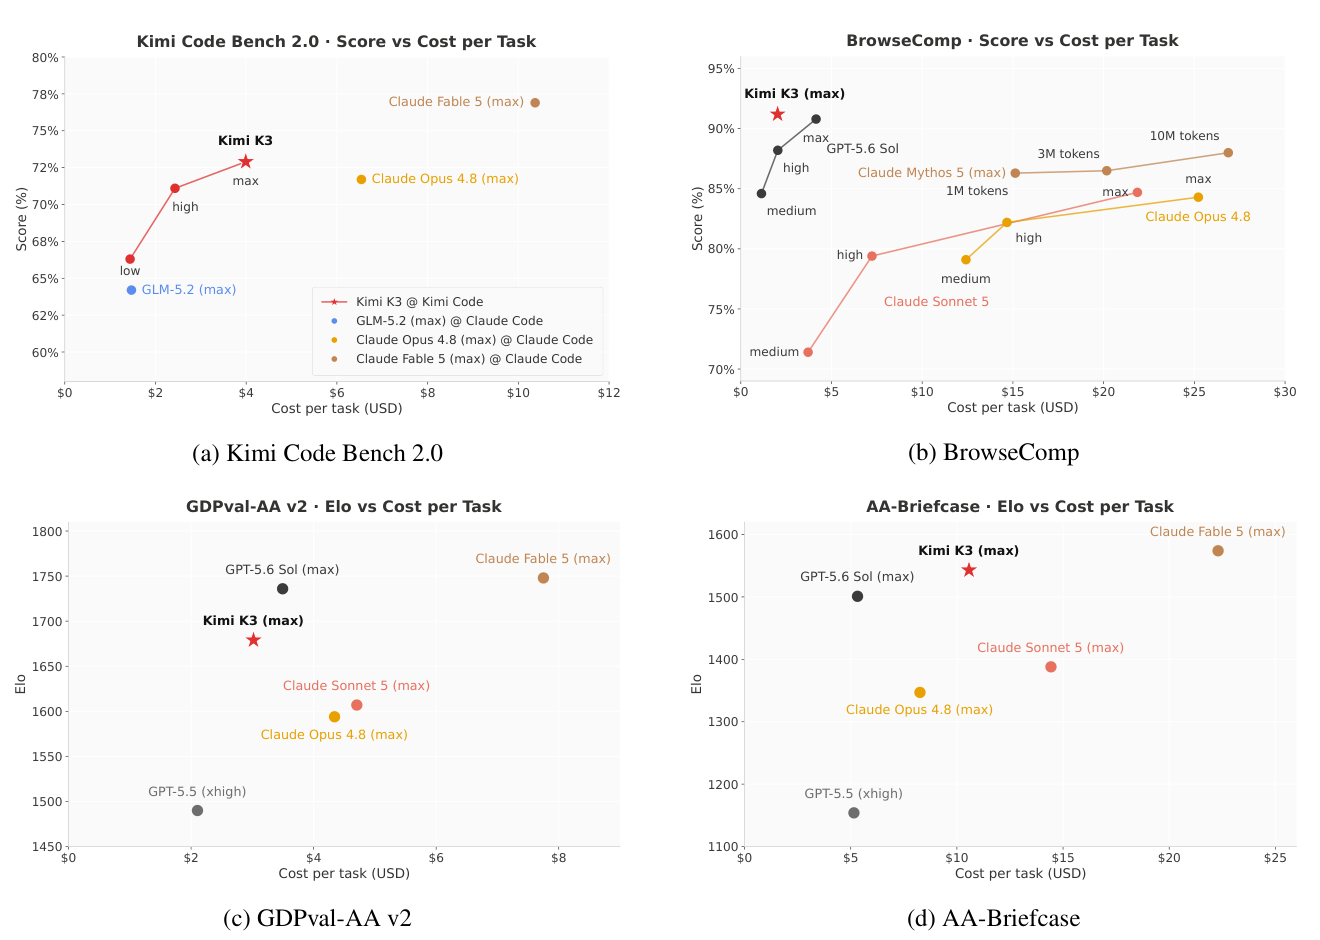
• BrowseComp:最佳分数 91.2%,单任务成本 $2.03——是 GPT-5.6 Sol 的一半,比 Claude 各模型最大力度低一个数量级
• GDPval-AA v2:与 GPT-5.6 Sol Elo 差在 50 以内,成本低 13%,比 Claude Fable 5 便宜 2.6 倍
• AA-Briefcase:第二高分,成本约为 Claude Fable 5 的一半
一句话:全部四个套件都位于或接近成本效率前沿,以零头成本交付接近最高的分数。
案例研究:不是嘴强,是真干过
Case Studies评测是考试,案例是实战。六个案例证明 K3 能独立完成复杂工程任务。
| 案例 | 做了什么 | 结果 |
|---|---|---|
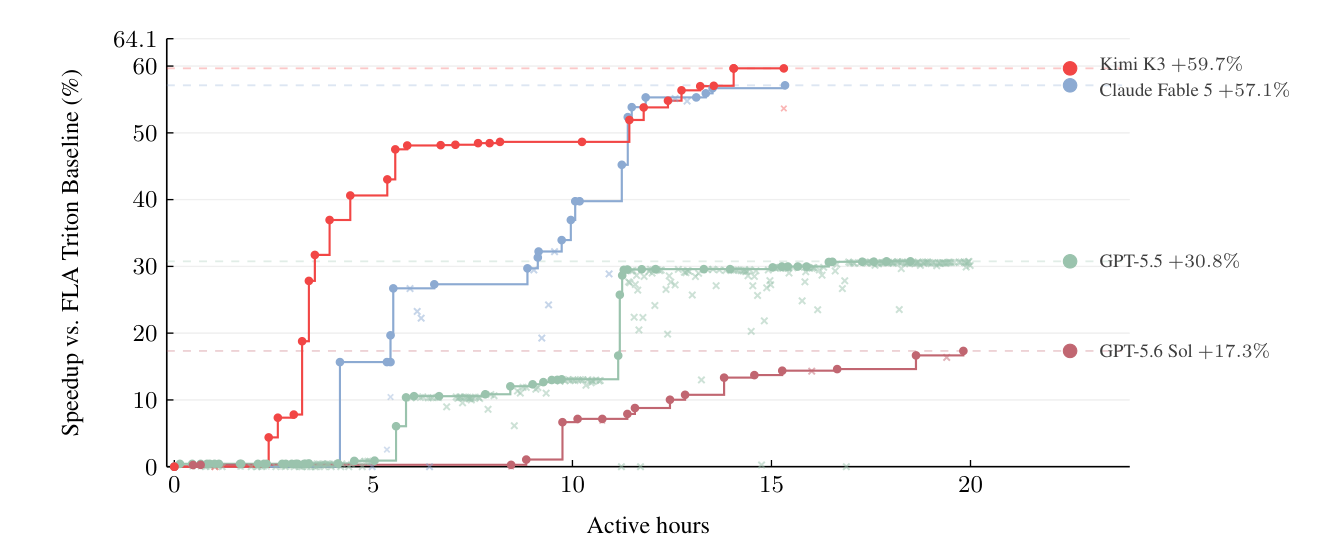
| GPU 内核优化 | 24 小时预算内优化 4 个内核(AttnRes/DSA/KDA/MLA) | AttnRes 延迟 283.6→114.4ms;DSA 削减 55.1%;KDA 削减 73.6%;MLA 达到峰值 TFLOPS 一半以上;与 Claude Fable 5 持平,大幅优于其他模型 |
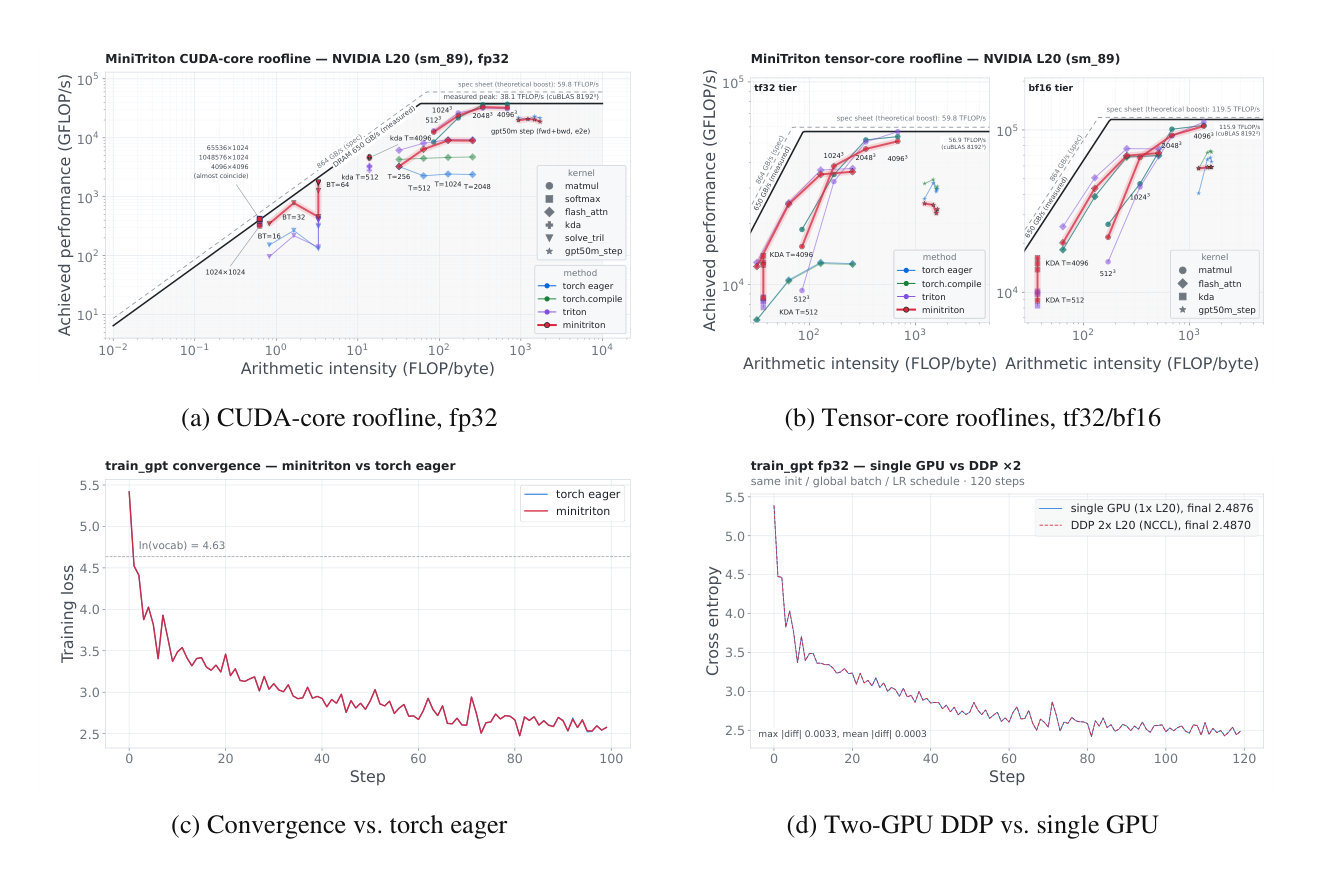
| GPU 编译器开发 | 从零写了 MiniTriton:类 Triton 编译器(tile 前端 + MLIR + PTX 生成)+ 双模式张量库 + 反向自动微分 + NCCL 分布式原语 | 几何平均性能优于 PyTorch eager 和 torch.compile;张量核矩阵乘逼近 cuBLAS(~90% roofline);DSL 级 KDA 内核明显优于 Triton 参考;能端到端训 GPT,梯度误差在 torch 自身 fp32 舍入误差内 |
| 芯片设计 | 48 小时自主运行,用开源 EDA 工具 + Nangate45 标准单元库设计推理芯片原型(KDA+NoPE-MLA+AttnRes+sigmoid MoE+INT4 量化) | 4mm² 内 100MHz 时序收敛;RTL 仿真解码 >8,700 token/s;146 万标准单元、0.277 MiB SRAM、融合反量化 INT4 MAC 阵列;RTL 已开源 |
| 科研编程 | 复现计算天体物理学 I–Love–Q 普适关系 | 查阅 20+ 篇论文、实现完整数值流水线、评估 300+ 状态方程、发现已发表公式的不一致、写 3,000+ 行 Python、产出交互式 HTML 仪表盘——约 2 小时,人类专家要 1–2 周 |
| 知识工作 | 制作 AI ASIC 产业 42 年历史的交互式研究网站;用 20+ 并发子智能体分析 GWTC-5 的 391 个引力波事件 | 120+ 轮迭代、87 份季报 + 99 份 PDF(11,000+ 页)、2,800+ 次网络搜索;产出七幅科学可视化、两张汇总表、综合十余篇论文的文献综述 |
| 视频剪辑 | 制作 3Blue1Brown 风格架构科普视频 + 用 56 个源片段剪预告片 | 片段筛选、动作匹配剪辑、帧级节拍同步、音频处理、多轮修改——资深剪辑师要 1–2 天的活 |
结论:开放的前沿
ConclusionKimi K3——全球首个开源的 3T 级模型,原生视觉 + 100 万 token 上下文,建立在 KDA 与 AttnRes 之上。在长周期编程、智能体、知识、推理和视觉任务上交付前沿级性能。
附录亮点:正文没展开的硬核细节
Appendices A–F| 附录 | 内容 | 人话 |
|---|---|---|
| A | 贡献者名单 | 数百人的团队,按姓氏字母序 |
| B | SiTU-GLU 细节 | 数学证明:为什么它在原点近似 SwiGLU(一阶吻合)、在大输入下有界(|f(x)| ≤ β₁β₂ = 100)、平滑封顶优于硬截断 |
| C | Quantile Balancing 推导 | 从「最优均衡分配」的线性规划出发,证明 QB 的偏置更新 = 对偶目标的精确坐标最小化解;一步 SignSGD 恰好恢复旧的符号更新法——解释了 QB 为何不需要学习率、几步就能均衡近千个专家 |
| D | 直方图分位数估计 | 分桶区间怎么定(被当前偏置界定)、怎么累积(scatter-add + all-reduce)、误差界(≤ 桶宽,B=1000 时误差 ~10⁻³)、EMA 平滑进一步降噪 |
| E | MoonEP 上界证明 | 定理 1:每 rank 预留 E/R 个冗余专家总能保证完美均衡;定理 2:这个上界基本是紧的(构造反例说明不可能显著更小) |
| F | XTML 对话模板 | 用三个保留特殊 token([open]/[sep]/[close])替代尖括号的类 XML 标记,三个设计目标:可扩展(单模板服务整个世代)、低对齐税(轻微微调就能直接进 RL)、解码友好(易做约束解码);选项消息设计让逐请求的修改不破坏 KV 缓存 |